A modelagem de dados é o alicerce silencioso de qualquer solução analítica corporativa. Quando um relatório do Power BI apresenta lentidão nas trocas de segmentadores ou as medidas DAX se tornam monstros incompreensíveis cheios de funções CALCULATE com filtros complexos, a causa quase nunca é a máquina do usuário ou a versão do software: é o modelo de dados subjacente.
Neste artigo, vamos explorar como implementar a Modelagem Dimensional Star Schema (Esquema Estrela) desenvolvida por Ralph Kimball e por que ela é o padrão-ouro absoluto para a engine colunar VertiPaq do Power BI.
O Problema das Tabelas Únicas ("Flat Tables")
No início de projetos ou ao importar dados brutos de planilhas e consultas SQL ad-hoc, é tentador trazer uma única tabela consolidada com 40 ou 50 colunas contendo tudo: dados do cliente, do produto, da transação financeira e da logística.
Embora pareça intuitivo, esse padrão traz prejuízos graves:
O Custo Oculto da Tabela Única:
- Inchaço de Memória: O VertiPaq compacta dados por coluna através de dicionários de cardinalidade. Repetir nomes e endereços de clientes em milhões de linhas de vendas destrói a taxa de compressão.
- Complexidade no DAX: Cálculos de inteligência temporal e agregações cruzadas exigem contextos de filtro artificiais, aumentando drasticamente o tempo de CPU no cálculo das métricas.
- Dificuldade de Governança: Qualquer alteração cadastral replica inconsistências históricas por todo o conjunto de dados.
Como Funciona o Star Schema
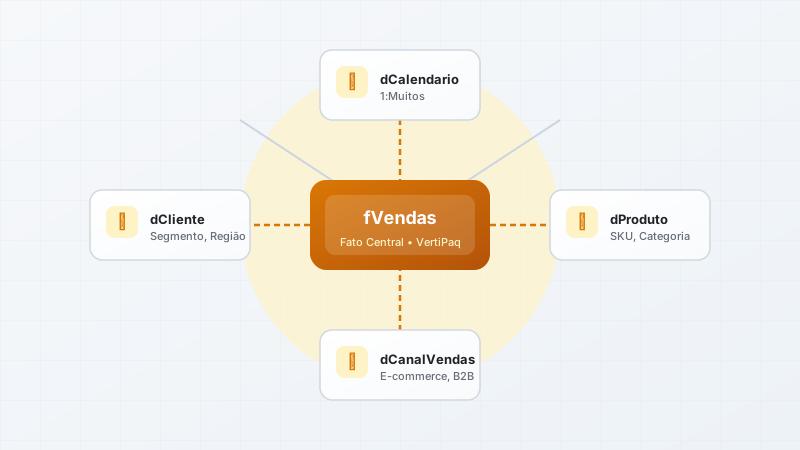
No Esquema Estrela, dividimos os dados em dois tipos fundamentais de entidades conectadas por relacionamentos de 1 para Muitos (1:*) com direção única:
           ┌────────────────────────┐
           │     dCalendario        │
           └───────────┬────────────┘
                       │ (1:*)
┌─────────────────┐    │    ┌──────────────────┐
│    dCliente     ├────┼────┤     dProduto     │
└────────┬────────┘    │    └────────┬─────────┘
         │ (1:*)       │             │ (1:*)
         └─────────┐   │   ┌─────────┘
                   ▼   ▼   ▼
             ┌──────────────────┐
             │     fVendas      │
             │   (Fato Central) │
             └──────────────────┘
1. Tabelas Fato (fVendas, fEstoque, fMetas)
Armazenam os eventos de negócio observados e suas métricas numéricas quantitativas (preço unitário, quantidade vendida, desconto concedido, margem bruta).
- Contêm chaves substitutas (Surrogate Keys ou IDs) que apontam para as dimensões.
- Crescem verticalmente (muitas linhas) e devem ser tão estreitas quanto possível (poucas colunas).
2. Tabelas Dimensão (dCliente, dProduto, dCalendario, dCanal)
Armazenam o contexto descritivo dos fatos — o quem, onde, quando, o que e como.
- Contêm valores únicos por registro (chave primária).
- São utilizadas nos eixos dos visuais, segmentadores e cabeçalhos de matrizes.
Star Schema vs. Snowflake: Por que não normalizar em excesso?
No modelo Snowflake (Floco de Neve), as dimensões são normalizadas em subtabelas (ex: dProduto conecta a dSubcategoria, que conecta a dCategoria).
| Aspecto | Star Schema | Snowflake |
|---|---|---|
| Relacionamentos | Diretos da Dimensão para a Fato | Cadeia de múltiplos relacionamentos |
| Performance VertiPaq | Máxima (menos saltos no plano de consulta) | Inferior (exige múltiplos JOINs internos) |
| Usabilidade do Usuário | Muito simples de navegar no campo de dados | Fragmentada em dezenas de tabelas |
| Recomendação Microsoft | Fortemente Recomendado | Evitar quando possível |
O Impacto Prático na Escrita de Medidas DAX
Com um Star Schema bem definido, as medidas DAX tornam-se naturalmente elegantes e limpas. Veja a diferença:
Exemplo: Vendas dos Melhores Clientes
-- Medida robusta e veloz aproveitando o relacionamento 1:* da dCliente
Vendas Clientes VIP =
CALCULATE(
    [Total Faturamento],
    dCliente[Segmento] = "Enterprise",
    KEEPFILTERS(dCliente[Status] = "Ativo")
)
Observe que filtramos a tabela dimensão (dCliente), e o contexto de filtro propaga de forma natural e instantânea para a tabela fato (fVendas), sem necessidade de funções de varredura onerosa como FILTER(ALL(fVendas), ...) que forçam o Storage Engine a materializar tabelas temporárias.
Checklist para a sua Próxima Modelagem
- Elimine colunas desnecessárias: Remova chaves de auditoria, timestamps irrelevantes e GUIDs de alta cardinalidade da tabela fato.
- Crie uma tabela dCalendario dedicada: Nunca utilize a auto date/time oculta do Power BI para modelos de produção.
- Mantenha a direção do filtro única: Relações bidirecionais devem ser exceções justificadas por cálculos complexos de transição de contexto, nunca o padrão.
- Oculte as chaves na tabela Fato: Deixe visíveis apenas as medidas e colunas numéricas de cálculo, forçando os usuários a utilizarem os atributos descritivos das dimensões.
Adotar o Star Schema não é capricho estético: é a garantia de que seu modelo suportará centenas de milhões de linhas com respostas em milissegundos e custo previsível de infraestrutura.

Marcos Aurélio
Senior Business Analytics com passagens por Nubank, Google e Asimov Academy. Especialista em traduzir dados complexos em decisões estratégicas de produto, IA e governança.