1. Contexto & Cenário Operacional
Na cadeia de suprimentos e manufatura industrial contemporânea, o volume de eventos gerados em linhas de montagem, sensores IoT de esteiras e transações de estoque é gigantesco. Cada segundo de paralisação ou inconsistência nos estoques reflete diretamente em milhões de reais em perda de produtividade.
A organização contava com um data warehouse legado acoplado a rotinas em scripts SQL executadas em fila noturna. Com o crescimento dos nós industriais, o volume saltou para mais de 15 milhões de linhas transacionais por dia. O processamento que antes demorava 1 hora passou a exigir mais de 4 horas e meia, estourando a janela noturna e provocando atrasos crônicos na disponibilização de relatórios gerenciais para o turno matinal de fábricas e centros de distribuição.
2. O Problema & Desafios Técnicos
Os gargalos eram tanto arquiteturais quanto de integridade de dados:
- Falta de atomicidade transacional (ACID): Se um job caísse no 80% do processamento, tabelas intermediárias ficavam corrompidas com registros duplicados ou pela metade, exigindo restaurações manuais desgastantes.
- Custos de computação em nuvem fora de controle: Máquinas virtuais rodavam dimensionadas para o pico máximo 24 horas por dia, queimando orçamento desnecessariamente.
- Acoplamento rígido de leitura e escrita: Consultas de analistas no início da manhã concorriam por I/O com os pipelines de carga atrasados, travando os bancos de dados relacionais.
3. Arquitetura Técnica & Stack Adotada
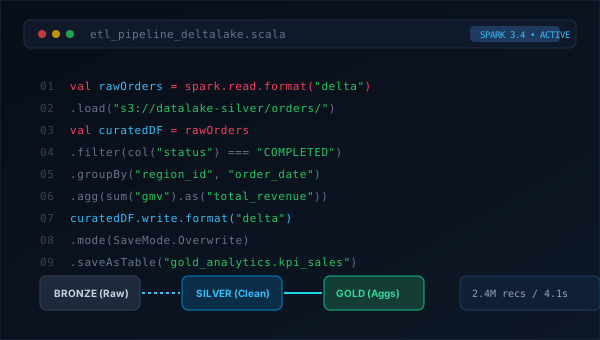
Para superar esses obstáculos, desenhamos uma modernização completa adotando o paradigma Lakehouse sobre o Databricks e AWS S3, estruturada no padrão Medalhão:
- Camada Bronze (Raw Ingestion): Ingestão raw em formato Delta Lake com preservação do payload original JSON/Parquet e metadados de auditoria (timestamp de ingestão, source file).
- Camada Silver (Conformed & Cleansed): Limpeza rigorosa, deduplicação por chave natural de evento, validação de schema e enriquecimento com tabelas dimensionais mestres.
- Camada Gold (Business Aggregations): Modelos analíticos sumarizados, tabelas fatos e data marts dimensionais otimizados para consumo veloz por ferramentas de BI e notebooks de Data Science.
- Otimizações Delta Lake: Aplicação de Z-Ordering pelas colunas de maior filtro (Data_Operacao, ID_Filial), particionamento inteligente e Auto-Compaction para erradicar o problema de "Small Files".
"A grande virada de chave do Delta Lake não é apenas velocidade bruta, mas a paz de espírito proporcionada pelas transações ACID e Time Travel. Saber que uma falha de pipeline nunca mais deixará a base em estado inconsistente transforma a dinâmica de trabalho de qualquer time de dados."
4. Implementação Passo a Passo
O projeto foi dividido em ciclos incrementais de entrega para não interromper os relatórios diários de fábrica:
Fase 1: Implementação de Contratos de Dados (Data Contracts)
Estabelecemos schemas estritos na fronteira entre os sistemas produtores e o Data Lakehouse. Qualquer divergência de tipagem ou ausência de campos obrigatórios é imediatamente desviada para uma Dead Letter Queue (DLQ), impedindo que registros malformados quebrem os estágios subsequentes.
Fase 2: Cluster Spark com Autoscaling Dinâmico
Substituímos clusters dedicados fixos por nós computacionais spot gerenciados dinamicamente pelo Databricks. O cluster escala horizontalmente durante a janela de pico de 35 minutos e é automaticamente desligado logo após a conclusão dos testes de qualidade de dados.
Fase 3: Governança Unificada com Unity Catalog
Centralizamos o catálogo de metadados, controle de acessos em nível de coluna e linhagem de ponta a ponta (data lineage). Agora é possível rastrear com precisão cirúrgica de qual sensor de fábrica derivou determinada métrica em um relatório de diretoria.
5. Resultados & Impacto Tangível de Negócio
Os benefícios tangíveis alcançados após a migração foram categóricos:
- O tempo de processamento total caiu de 4h30 para apenas 35 minutos, garantindo relatórios consolidados às 06:00 pontualmente.
- A despesa mensal com infraestrutura computacional em nuvem caiu em -65% devido ao uso de nós sob demanda e otimização Z-Order do Spark.
- Conformidade com 100% de integridade ACID, eliminando por completo os incidentes de tabelas corrompidas e retrabalho manual.
- Adoção unificada por mais de 80 engenheiros, analistas e tomadores de decisão em operações de fábrica.
6. Principais Aprendizados & Lições do Marcos
"Engenharia de dados não se resume a mover bytes de um lugar para o outro. É a arte de construir pontes confiáveis entre o caos transacional da operação e a clareza estratégica da tomada de decisão. Quando o dado é confiável e chega no tempo certo, a liderança deixa de discutir se o número está certo e passa a discutir o que fazer com ele."